Design Harness 是什么?我在 KinoViz 中构建设计类 AI Agent 的实践
为了实践最近很火的 Harness,我打造了 KinoViz。这个过程确实很艰辛😅,但现在终于能产出一些不错的结果。以下是我在产品实践中积累的一些经验,希望能和大家、同行共勉。
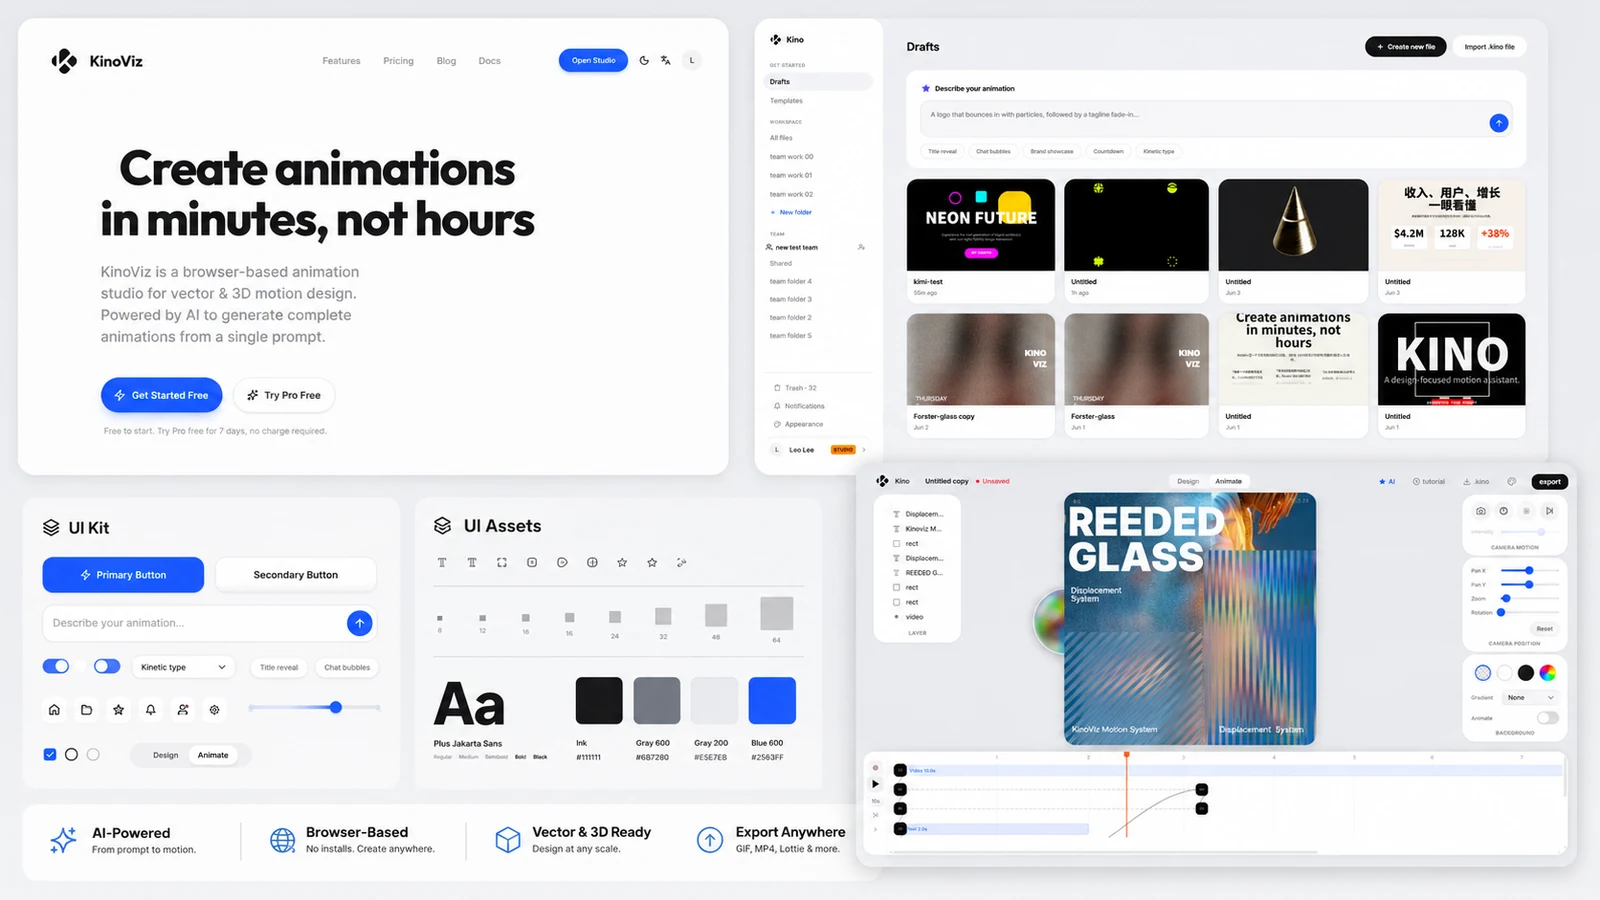
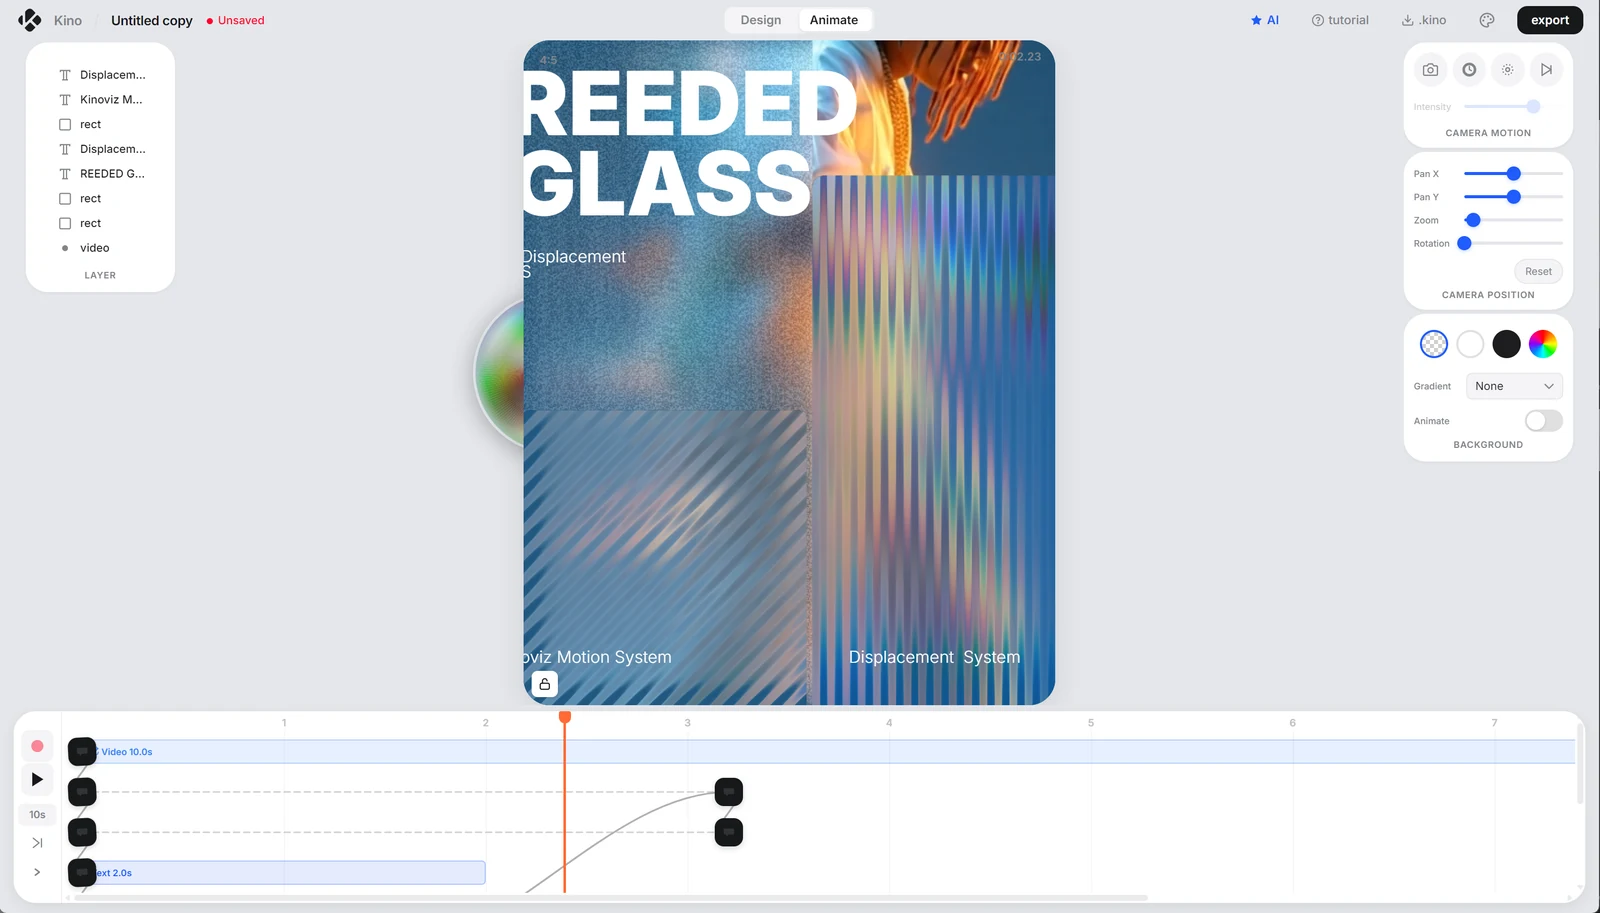
先看目前做到的效果
参考图模式生成动画
以我当前的实践为例,这类任务需要使用 GPT-5.5 以上的高级模型,或者 Claude Opus 4.7 以上的模型。
视频演示:请参考上方动图。
视频演示:请参考上方动图。
文生动画:自由创作
文生动画:UI 界面
这类动画比较固定,做了规范的限制,避免模型随意发散

AI 做动画,只是入口
如果先看效果,读者的第一反应大概率是:AI 又能做动画了。
但我真正想讲的不是“模型能生成一段好看的动画”。
那只是入口。
真正有价值的部分在后面:这段效果生成之后,它不是一张死图,也不是一个只能看不能改的 demo。它应该仍然保留图层、角色、颜色语义、关键帧、素材来源、项目状态和回滚路径。用户可以改字、换风格、调节奏、换素材、继续让 Agent 接着做。
这才是我最近一直在研究的东西:Design Harness。
我过去也会把这个词写成 Hardness。误写不完全离谱,因为这件事确实很 hard。难点不在于让模型“出一张图”,而在于让模型进入真实设计工作流,稳定地产出可编辑、可验证、可继续生产的结果。
一句话说:
Design Harness 不是让 AI 更会“画”,而是让 AI 更会“交付设计工作”。
业界讲的 Harness,落到设计里是什么
DeepSeek 的 Harness JD 里有一句很直接的话:Model + Harness = Agent。
Anthropic 在 agent eval 的文章里也有类似表述:agent harness / scaffold 是让模型像 Agent 一样行动的系统,它负责处理输入、编排工具调用、返回结果。OpenAI Agents SDK 文档则把 Agent 定义为会计划、调用工具、跨 specialist 协作、保持状态以完成多步任务的应用,并明确说,当应用拥有 orchestration、tool execution、approvals、state 时,就进入了 Agents SDK 的范畴。Google Cloud 对 Agent 的拆法也很清楚:reasoning、planning、memory、tools,再加一定自主性。
这些说法放到设计场景里,可以翻译成一个更具体的问题:
模型如何从一句模糊需求,走到一个可以继续编辑和发布的设计文件?
我的答案是下面这条链路:
效果不是终点。效果只是让读者和用户愿意继续看的第一屏。
真正的系统应该从效果往回拆:用户意图是什么,brief 如何形成,审美标准来自哪里,工具怎么暴露,生成结果如何保留结构,动画如何被验证,最后如何导出和回滚。
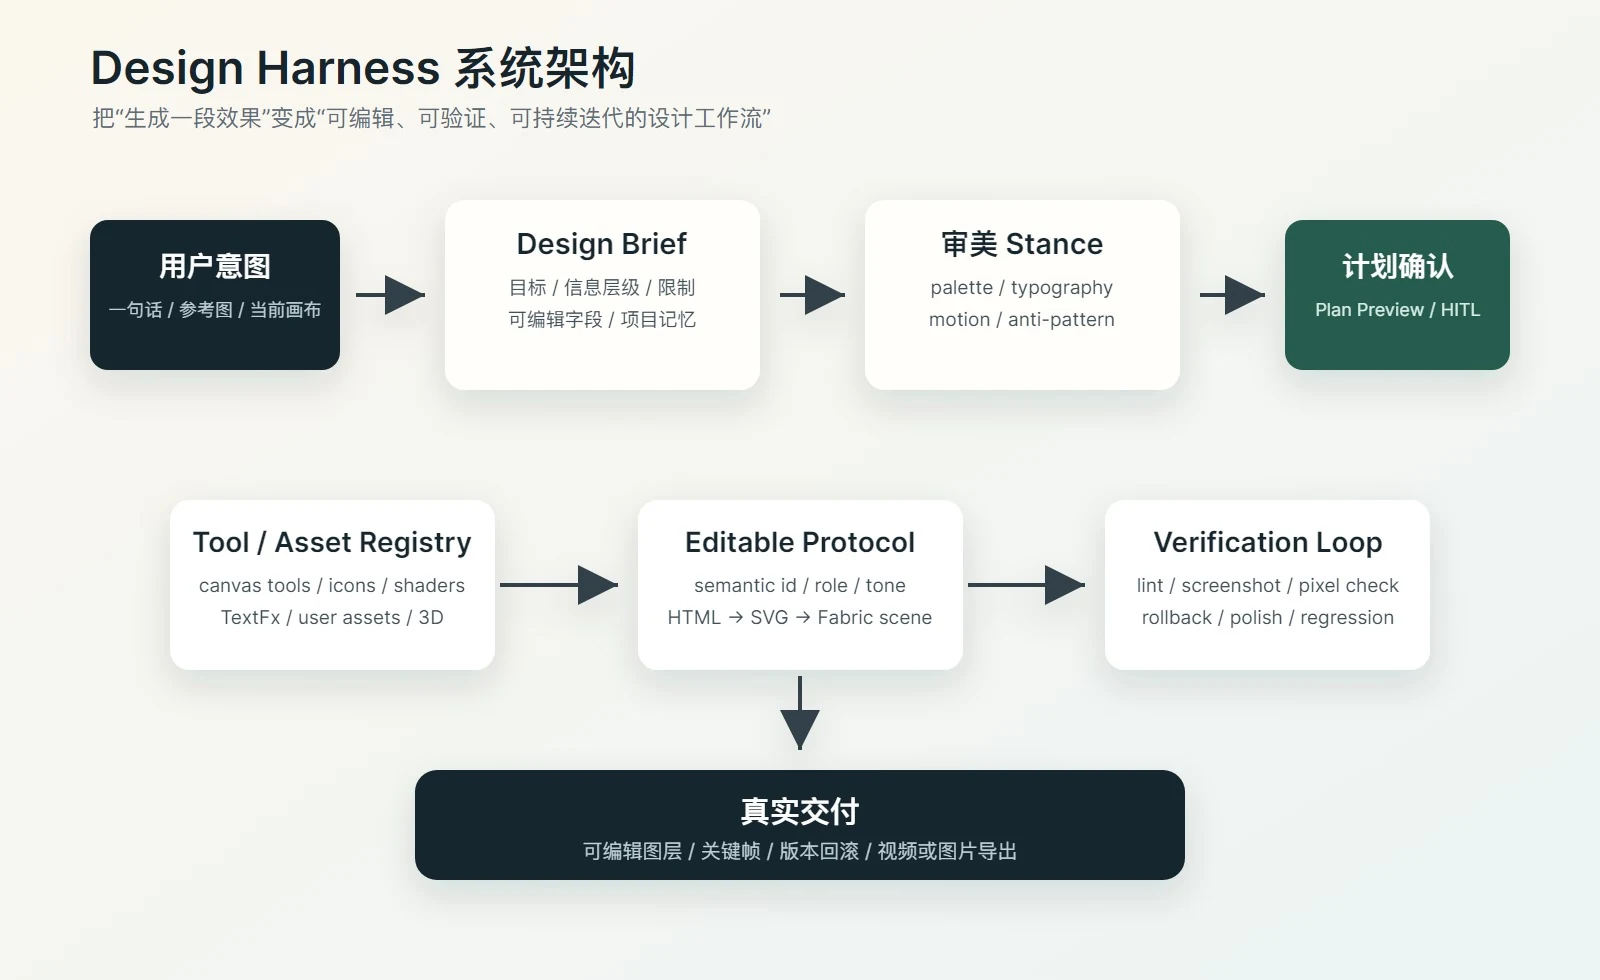
我把它拆成六层:
- 用户意图:一句话、参考图、当前画布、历史上下文。
- Design Brief:把模糊需求变成模型和用户都能检查的合同。
- 审美 Stance:让模型知道“什么算好”,而不是只说“高级一点”。
- Tool / Asset Registry:让模型看见真实编辑器能力和已有资产。
- Editable Protocol:把生成物变成结构化、可编辑的场景。
- Verification Loop:用规则、截图、回归和人工 polish,让结果能稳定进步。
这六层合在一起,才是 Design Harness。
第一层:先给效果,但不要被效果骗了
设计类 AI 产品特别容易被首图效果带偏。
你做出一个漂亮 demo,用户会兴奋,朋友圈会转发,投资人也容易看懂。但创作工具一旦进入真实工作流,第一张图很快就不够用了。
用户马上会问:
这行字能改吗?
这个按钮能换颜色吗?
这个光效能弱一点吗?
这个元素能晚 0.2 秒进场吗?
这个动效能导出 MP4 吗?
这个版本能回滚吗?
所以我现在判断一个 AI 设计工具,不再只看第一屏生成效果,而是看第十次修改时,系统还剩多少结构。
如果第十次修改时,用户仍然能选中 headline、改 CTA、换 palette、调 keyframe、复用资产、重新导出,这才说明 Harness 有价值。
这也是 KinoViz 里我最看重的方向:效果先让人愿意看,结构让人愿意继续用。
第二层:Brief 是模型和人的合同
用户 prompt 往往太短。
“做一个 hello 动画。”
“做一个 fintech hero。”
“帮我生成一个更高级的页面。”
这些话对人类设计师来说也不够,更不用说模型。模型只能猜。猜一次可以,连续工作就会漂。
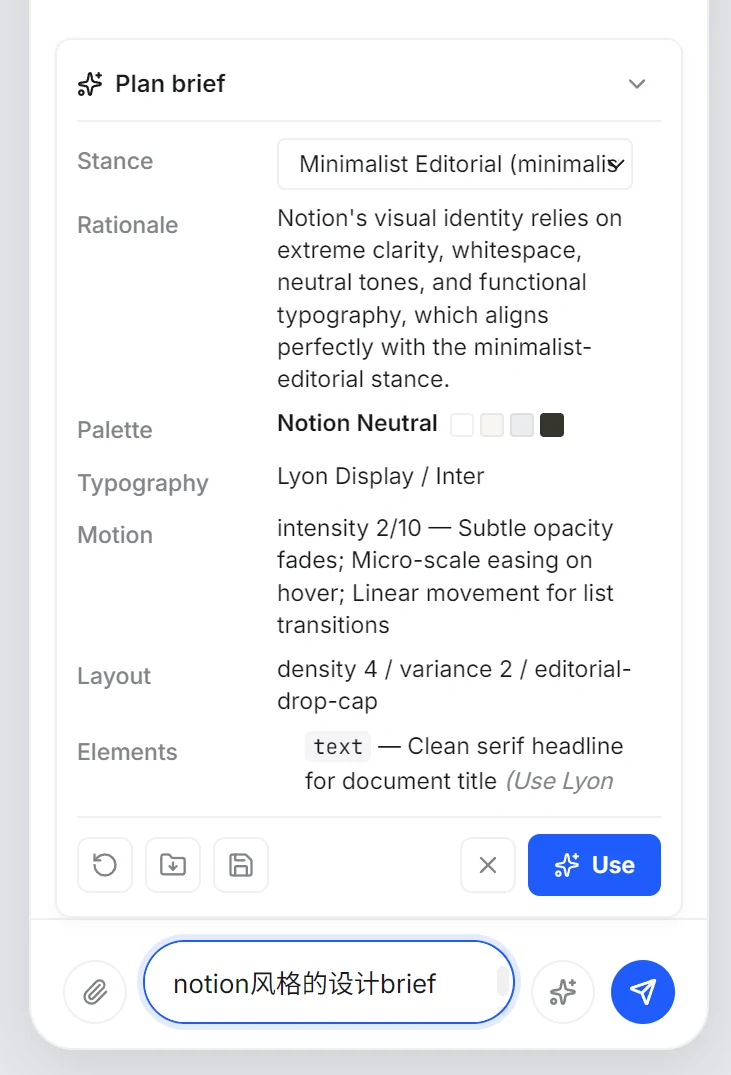
所以我把 raw prompt 变成一个中间层:Design Brief。
它不是写给用户看的漂亮说明,而是写给模型、系统和用户共同检查的合同。
一个简化版 brief 大概长这样:
type DesignBrief = {
  goal: string;
  audience?: string;
  industry?: string;
  stance: "minimalist-editorial" | "glassmorphic-tech" | "kinetic-poster" | string;
  palette: {
    name: string;
    background: string;
    ink: string;
    muted: string;
    accent: string;
    surface: string;
  };
  typography: {
    display: string;
    body: string;
    hierarchy: "editorial" | "dashboard" | "poster" | "product-ui";
  };
  motion: {
    personality: "calm" | "springy" | "kinetic" | "cinematic";
    intensity: 1 | 2 | 3 | 4 | 5;
    maxDurationMs: number;
  };
  layout: {
    density: 1 | 2 | 3 | 4 | 5;
    variance: 1 | 2 | 3 | 4 | 5;
  };
  editableFields: string[];
  constraints: string[];
};
这段不是项目源码,只是我对 brief 的抽象。
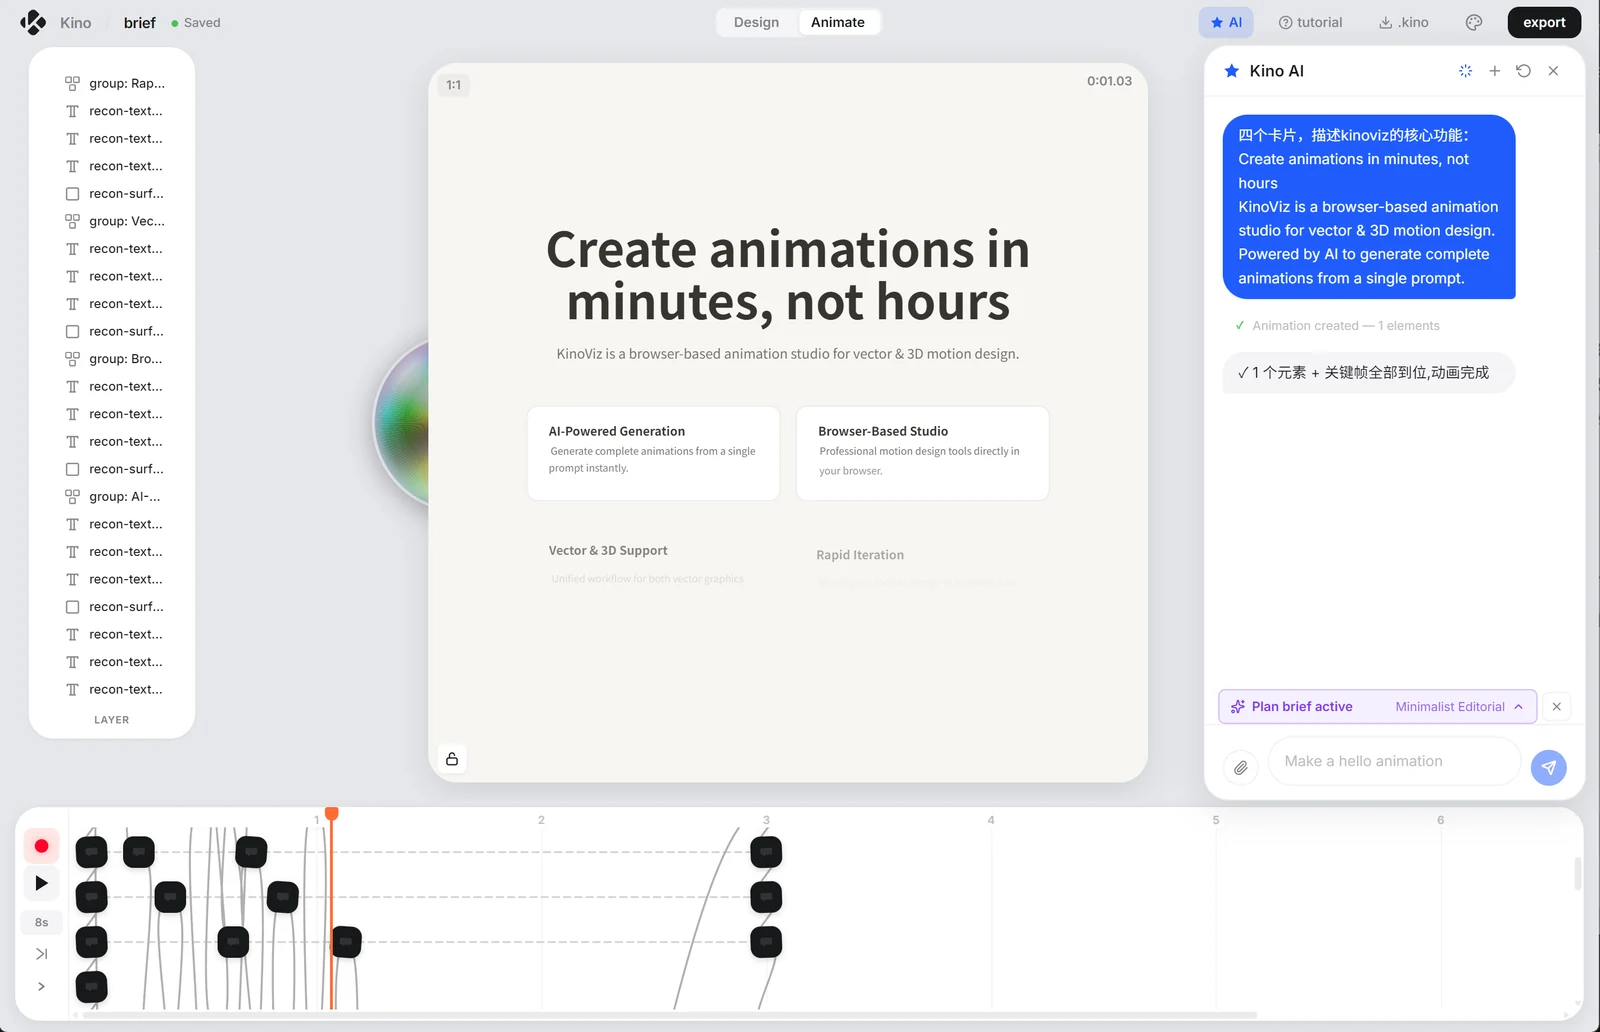
关键点不在字段本身,而在它解决了三个问题。
第一,模型不用每轮重新猜风格。
项目级 brief 可以持久化。今天生成 hero,明天改 pricing,后天补 stats,Agent 每轮都读同一份设计意图。页面不会一屏一个审美。
第二,用户可以在生成前介入。
如果模型判断用户需求太模糊,它应该先给出 Plan Preview,而不是直接改画布。Plan Preview 里可以放 stance、palette、时长、元素列表、镜头、关键问题。用户确认后再执行 mutating tools。
第三,后续验证有了依据。
如果 brief 写了 motion.intensity = 2,结果却生成一堆剧烈弹跳和闪烁,那不是“审美偏好不同”,而是违反合同。
很多人把 Context Engineering 理解成“塞更多上下文”。我现在更愿意理解成“把上下文分层”:哪些是当前对话,哪些是项目记忆,哪些是可 lazy-load 的知识,哪些必须让用户确认。
Brief 就是设计类 Agent 最重要的上下文中间层。
第三层:审美 Stance,让“美”可操作
设计 Harness 最大的难点之一,是如何让模型理解“美”。
这句话听起来玄,但工程上可以拆解。
模型默认很容易陷入模式坍塌(mode collapse)。它会回到训练分布中最安全的模板:紫蓝渐变、大圆角卡片、emoji 图标、空泛的 feature 文案、三段式 hero、看起来像 SaaS 但没有具体产品气质。
所以我没再对模型说“更高级”“更有设计感”,而是把审美拆分为 stance。
一个 stance 不是一个风格名称,而是一套设计人格:
- 适合什么行业和场景。
- 应该使用什么字体关系。
- 主色、辅助色、强调色如何分工。
- 页面密度应该高还是低。
- 布局应该稳定还是有张力。
- 动效应该克制、弹性、机械,还是电影感。
- 哪些东西绝对不要出现。
抽象后大致如下:
type AestheticStance = {
  id: string;
  useWhen: string[];
  avoidWhen: string[];
  palette: {
    background: string;
    ink: string;
    muted: string;
    accent: string;
    surface: string;
  };
  typography: {
    display: string;
    body: string;
    rule: string;
  };
  motion: {
    rhythm: string;
    easing: string[];
    antiPattern: string[];
  };
  composition: {
    density: number;
    variance: number;
    preferredLayouts: string[];
  };
};
比如同样是“产品发布 hero”,不同 stance 会产生截然不同的结果:
Minimalist Editorial 偏向克制、留白、清晰的文字层级。
Glassmorphic Tech 偏向深色、折射、轻微的弹簧感和空间感。
Kinetic Poster 会让大字占据 70% 画布,强调切分、滚动、错位和节奏。
Organic Nature 会把颜色、形状和动效都降下来,营造呼吸感和手工感。
这一步的价值,在于把“品味”从一句评价,变成模型可以选择、继承、检查并局部改写的系统。
当然,规则不能替代品味。
但没有规则,模型很难稳定继承你的品味。
我后来还把一些明显的 AI 味变成了反模式:默认 indigo、廉价紫蓝渐变、emoji 当图标、虚构指标、占位符文案、没有语义 ID 的图层。能 lint 的就 lint,不能 lint 的就写成 reviewer checklist。
这不是为了把设计变成死板规范,而是给模型建立最低审美门槛。
先不犯低级错误,才谈得上做出 20% 的独特选择。
第四层:工具暴露完整,模型才像真的会用编辑器
很多 Agent 效果差,不是模型不聪明,而是工具接口太差。
编辑器里明明有 pen、path、mask、boolean、group、keyframe、camera、background、TextFx、GLSL、icon、3D、用户资源,但 Agent 只看到 add rectangle、add text、modify element 这类粗工具,它当然做不出真正的设计动作。
我踩过很典型的坑:系统 prompt 宣称某个工具可用,tool registry 里也注册了,但前端 client tools 白名单没有同步,bridge handler 也没接上。模型调用了,界面却没执行。
这类问题在 Harness 里非常致命。
所以工具注册必须成为 single source of truth。
一个工具不只是函数名,而应有完整元数据:
type AgentToolMeta = {
  name: string;
  category: "canvas" | "asset" | "analysis" | "generation";
  modes: Array<"agent" | "animation" | "image">;
  mutating: boolean;
  needsApproval?: boolean;
  costLevel: "free" | "credit" | "expensive";
  useWhen: string;
  doNotUseWhen?: string;
  returns: "canvas-diff" | "asset-list" | "plan" | "diagnosis";
};
这里最关键的是 mutating。
聊天、检索、分析、查 skill 可以开放。真正改画布、生成资产、消耗额度、写入项目状态的操作,需要权限、plan gate、用户确认和回滚。
这和 OpenAI 文档里的 approvals、state 是同一个方向,也与 Anthropic 讲的 checkpoint、人类反馈相通。
设计工具里还有一类特殊工具:资产发现。
模型不应该每次都从零生成。
它应该先问:有没有现成 TextFx?有没有 GLSL shader?有没有 icon?用户项目里有没有刚生成过的图?有没有可复用的 3D 模型、材质、HDRI?
所以我把资产也看作工具的一部分:
type AssetSearchQuery = {
  type: "icon" | "textfx" | "shader" | "user-image" | "model" | "material" | "all";
  query: string;
  projectId?: string;
  limit?: number;
};
这个设计背后的判断是:复用不是偷懒,复用是设计工作流。
一个真正可用的 Design Agent,不应只会生成,也应会找、会选、会组合、会继承项目资产。
第五层:Editable Protocol,才是“恍然大悟”的地方
这可能是我对 Design Harness 最核心的理解。
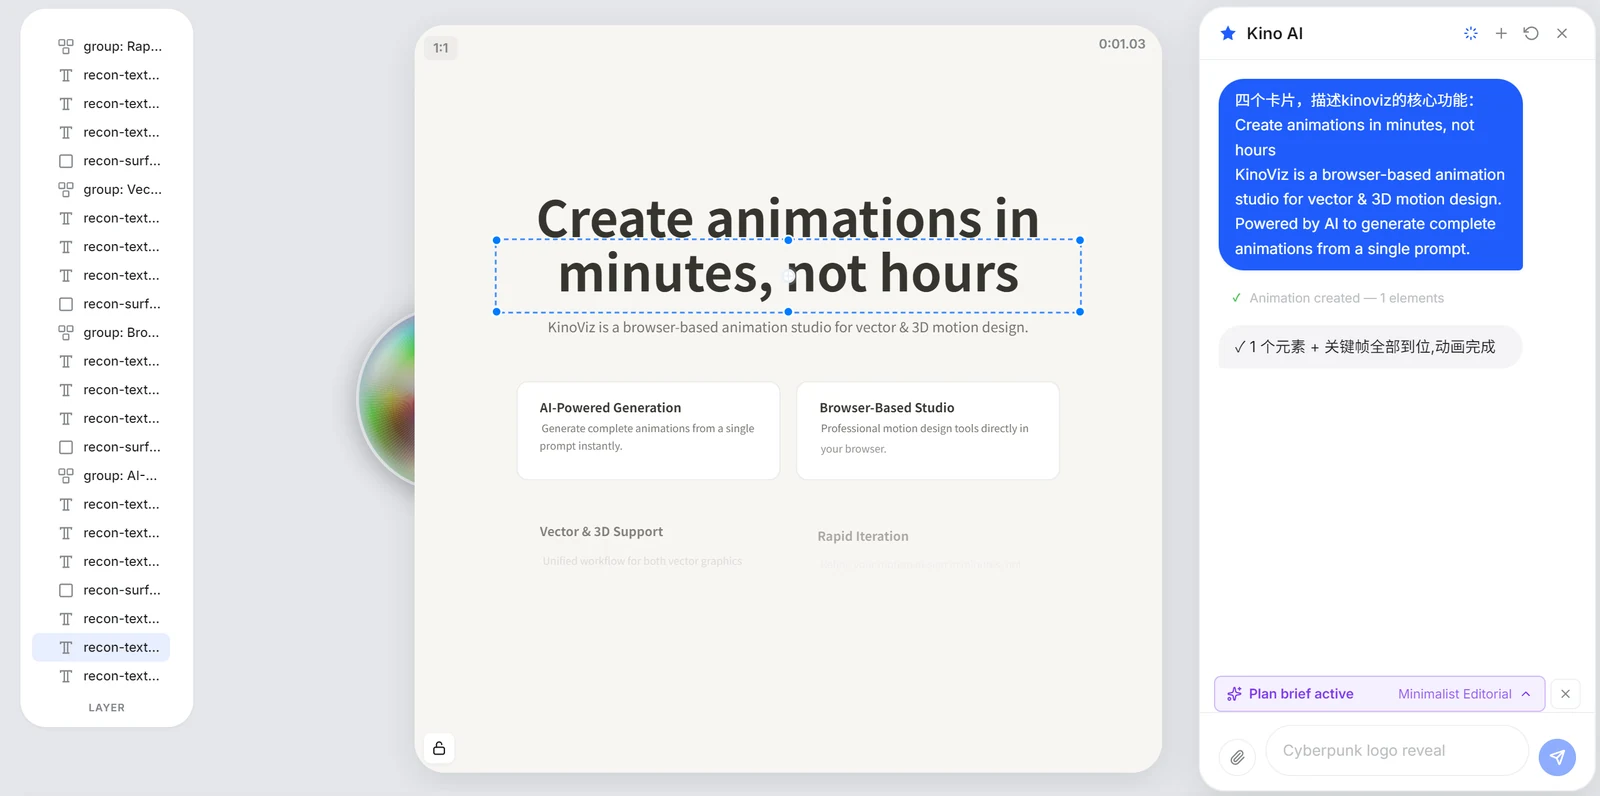
如果模型最后只输出一张图片,那么它再好看也只是结果。
如果模型输出的是一棵可编辑的设计树,那么它才进入了生产。
所以生成路径不能只追求视觉相似,还要保留语义结构。
我在 KinoViz 里研究过 HTML → SVG → Fabric.js scene 的链路。这里不展开具体实现,只讲思路:让模型先用受限 HTML 表达结构,再通过语义标记把 DOM 映射到 SVG,再把 SVG / role / tone / animation 还原成 Fabric.js 场景。
一个概念化片段大致如下:
<div
  data-kv-id="hero-root"
  data-kv-group="hero"
  data-kv-layout="stack"
  data-kv-tone="background"
  style="display:flex; flex-direction:column; gap:24px;"
>
  <span
    data-kv-id="hero-eyebrow"
    data-kv-role="eyebrow"
    data-kv-tone="accent"
    data-kv-anim="fadeInDown"
  >
    PRIVATE BETA
  </span>

  <span
    data-kv-id="hero-headline"
    data-kv-role="headline"
    data-kv-tone="ink"
    data-kv-anim="fadeInUp"
  >
    Ship faster with signal
  </span>

  <span
    data-kv-id="hero-cta"
    data-kv-role="cta"
    data-kv-tone="accent"
    data-kv-emphasis="true"
    data-kv-anim="scaleIn"
  >
    Start free trial
  </span>
</div>
这里的重点不是 HTML。
重点是 data-kv-* 这一层语义协议。
data-kv-id 让后续编辑和测试有稳定锚点。
data-kv-role 告诉系统这是 headline、subtitle、CTA、price、metric 还是 feature item。
data-kv-group 和 data-kv-layout 告诉系统哪些元素属于同一个语义组,应该如何形成图层和 stagger。
data-kv-tone 是颜色语义,不是颜色值。模型可以说这是 accent,但真正的 accent 来自 brief palette。这样用户切换 stance 时,结构不动,视觉可以整体重算。
data-kv-anim 只引用 preset,不让模型随便写一堆不可控动画。
这就是我所谓的“可编辑协议”。
它让 AI 输出不再是扁平图片,而是一个可恢复为设计工具对象的中间表示。
这也是读者应该恍然大悟的地方:
真正的 Design Harness,不是让模型直接画出最终画面,而是让模型产出一个可被设计工具理解的结构。
第六层:动效 Harness,比静态设计更难
静态设计已经很难,动效更难。
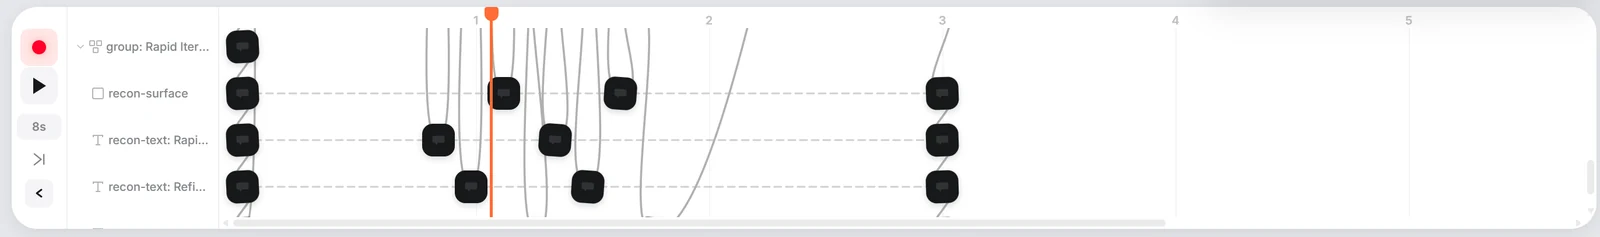
因为动效多了时间。
时间一进来,问题就多了:关键帧、节奏、延迟、镜头、stagger、缓动、循环、暂停、reduced motion、闪烁阈值、导出一致性。
我现在对动效的判断比较克制:动效不是装饰,它应该服务空间、时间和状态变化。
比如一个元素入场,用户应该更清楚信息层级。
一个卡片展开,用户应该知道空间关系发生了什么。
一个状态完成,用户应该得到反馈,而不是被表演打断。
因此动效 Harness 里至少要有四个东西。
第一,Plan Preview。
完整创作类任务,不应该上来就改画布。模型应该先给方案:背景、镜头、元素、入场顺序、总时长、动效性格、用户需要确认的问题。用户确认后再执行。
第二,Motion Budget。
每类动效都要有时长和强度预算。按钮反馈、状态确认、入场、跨屏转场,不应该混用同一套节奏。频繁动作要短,展示型动作可以长一点,循环动效要可停。
第三,Keyframe Sanity Check。
生成后要检查画布是不是空的,关键帧是不是缺失,时长是不是异常,某个元素是不是有几十个无意义 keyframe,是否有过度闪烁。
第四,Export Parity。
编辑器里看起来对,不代表导出一定对。Fabric 渲染、背景采样、滤镜、玻璃效果、嵌套 group、mask、DPR、视频导出,都可能出错。动效 Harness 必须关心编辑器预览和最终导出的一致性。
一个简化的检查器可以长这样:
const designChecks = [
  "canvas_is_not_empty",
  "all_visible_elements_have_semantic_id",
  "headline_uses_stance_display_font",
  "no_default_ai_indigo",
  "no_placeholder_copy",
  "animation_duration_within_budget",
  "no_flash_more_than_3_times_per_second",
  "keyframes_exist_for_animated_elements",
  "editor_preview_matches_export_snapshot"
];
这里也不是项目源码,而是说明一种思路:
把“看起来不对”拆成尽可能多的可检查项。
有些审美无法自动判断,但很多低级错误可以。
只要能挡住 60% 的低级错误,人工 polish 就能集中在真正的设计判断上。
验证循环:不要把所有评估都交给模型
Agent 产品很容易迷信“让 AI 自我反思”。
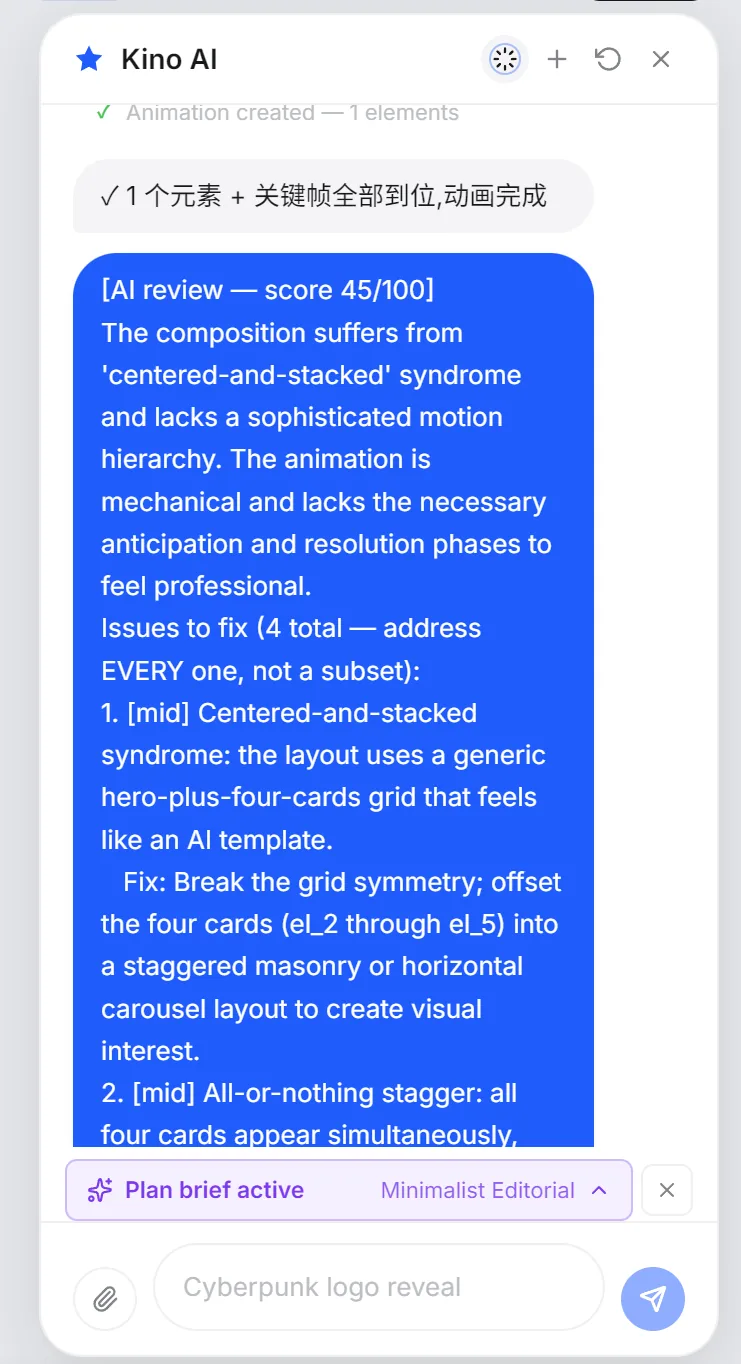
自我反思有用,但不能包治百病。
尤其是设计场景,模型有时会很自信地解释一个很差的结果。你让它评估自己,它会给你一段合理的理由,但画面仍然不对。
所以我更倾向于混合验证:
规则检查解决明确错误。
截图和像素检查解决渲染差异。
E2E 测试解决工具链是否断裂。
人类 polish 解决品味判断。
模型 review 只在它擅长的地方介入,比如解释问题、提出修改方向、生成替代方案。
这和 Anthropic 讲的 long-running agents 很接近:长任务要靠 feature list、incremental progress、clean state、progress file、端到端测试,让 Agent 不断重新获得方向感。设计类任务同样需要这些,只是测试对象从代码变成画布、图层、截图和导出物。
我的体会是:
Harness 不是让 Agent 无限自由。
Harness 是给 Agent 一条可以自由工作的轨道。
还有哪些业界概念可以继续补进工程
我现在做的 Design Harness,还不是终局。
如果继续往深处走,业界已有的几个方向都值得接进来。
第一,Eval Harness。
Anthropic 讲 agent eval 时强调,评估的是模型和 harness 共同工作的结果。设计类 Agent 也应该有自己的 eval:生成质量、可编辑性、工具命中率、回滚成功率、导出一致性、用户二次修改次数、人工 polish 成本。
第二,Sandbox / Execution Separation。
OpenAI 的 sandbox agents 文档里强调 harness 可以跑在你的基础设施里,而 sandbox 负责有状态执行。设计工具里也有类似问题:Agent 决策、工具执行、文件导出、用户资产访问,最好有清晰边界,避免一个工具调用造成过大影响面。
第三,Memory Governance。
项目 brief 是一种记忆,但未来还可以有品牌记忆、团队设计系统记忆、用户偏好记忆。难点不是记得越多越好,而是记什么、何时记、如何过期、如何让用户可编辑。
第四,Subagent / Specialist。
复杂设计任务可以拆成多个 specialist:brief analyst、layout designer、motion designer、asset finder、reviewer、export verifier。但我不倾向于为了多 Agent 而多 Agent。只有当任务复杂到单 Agent 难以稳定完成,或者确实需要并行探索和交叉验证时,它才值得。
第五,Trace / Observability。
设计 Agent 最终也需要可观测性。一次生成为什么选了这个 stance,为什么调用这个工具,哪个检查失败,哪一步消耗最多时间,用户在哪一步取消,这些都应该进入 trace。
这些都可以作为后续工程补充。
但我会先坚持一个顺序:先把单 Agent 的 Design Harness 打稳,再谈多 Agent 和更重的调度系统。
我现在对 Design Harness 的结论
Design Harness 的核心不是“帮模型多写一点 prompt”。
它是一套让模型进入设计生产的外部系统。
它要回答六个问题:
模型如何理解目标?
模型如何继承审美?
模型如何知道自己有哪些工具?
模型如何把生成结果保留为可编辑结构?
模型如何处理时间和动效?
模型如何验证、回滚、导出,并继续迭代?
如果这些问题没有答案,AI 设计工具就容易停在“生成器”阶段。
如果这些问题都有工程答案,AI 才可能从“会生成”进入“能交付”。
这也是我做 KinoViz 这段时间最大的收获:
我不是只在做一个 AI 动画工具。
我是在研究设计类 Agent 的 Harness。
效果是表层,结构是底层。模型是发动机,Harness 是整辆车。
未来模型会继续变强,但模型之外的工程会越来越重要。
谁能把模型能力接进真实工作流,谁就能把 AI 从“看起来很神”推进到“真的能干活”。
这就是 Design Harness 最值得投入的地方。
仍然不完美
目前 AI Agent 尚处于 Beta 阶段,还在完善中,且背后需要使用 GPT-5.6 以上模型,成本很难降得下来,所以目前的积分消耗较高。
如果你也在探索可编辑的 AI 动画工作流,可以从 KinoViz Studio 开始体验,并在真实项目里继续验证这套 Design Harness 思路。